大模型的记忆本质是键值对检索。通过引入非线性函数与Softmax,记忆容量从几十个跃升至百万级,最终推导出Transformer结构。
今天的语言模型能够轻松记住海量的世界知识,但在底层,模型究竟是如何存储和检索这些信息的?如果把神经网络的每一层看作一个“关联记忆库”,信息以键值对的形式存入:输入查询键,检索出对应的数值。当存储的信息越来越多时,非目标键就会对检索产生干扰。当干扰信号盖过真实信号时,记忆库就达到了容量极限。
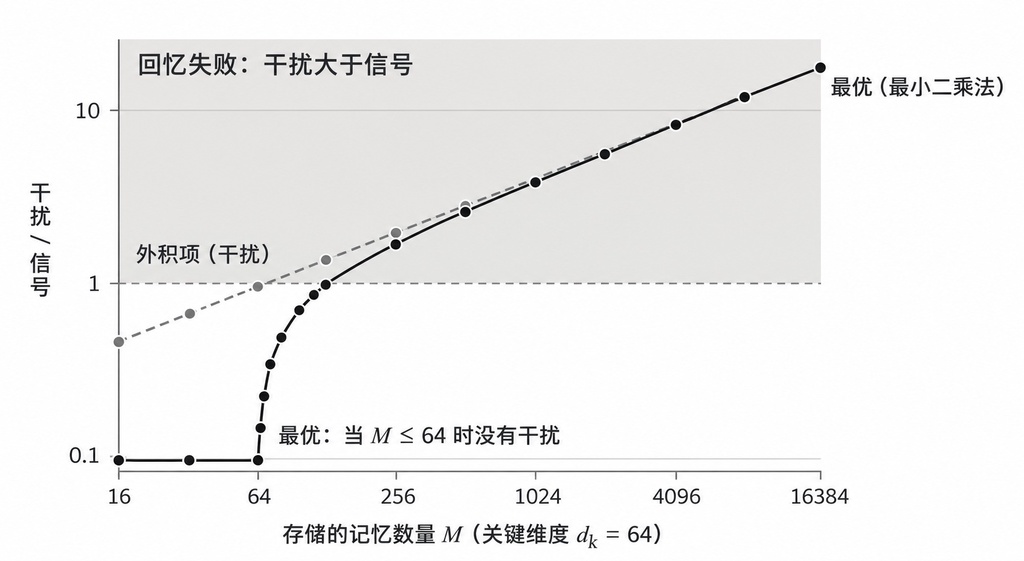
最基础的记忆库是线性层。它通过外积累加将键值对直接写入权重。在64维的键向量空间中,线性层只能无错存入约64个记忆。即使使用最小二乘法进行最佳线性优化,消除了键之间的冗余,记忆容量也仅仅翻倍到128个。
要大幅提升容量,就必须抑制低相似度键带来的干扰。在神经网络中引入非线性激活函数,就是实现选择性检索的关键。前馈神经网络(MLP)通过激活函数滤除无关干扰:简单的ReLU函数能过滤负相似度,将容量提升至128个;平方ReLU(以及现代模型常用的SwiGLU)能够大幅压低接近零的微弱干扰,让容量呈现几何级增长,在64维空间中直接飙升至约2700个;立方ReLU则能将容量进一步推高至约35000个。
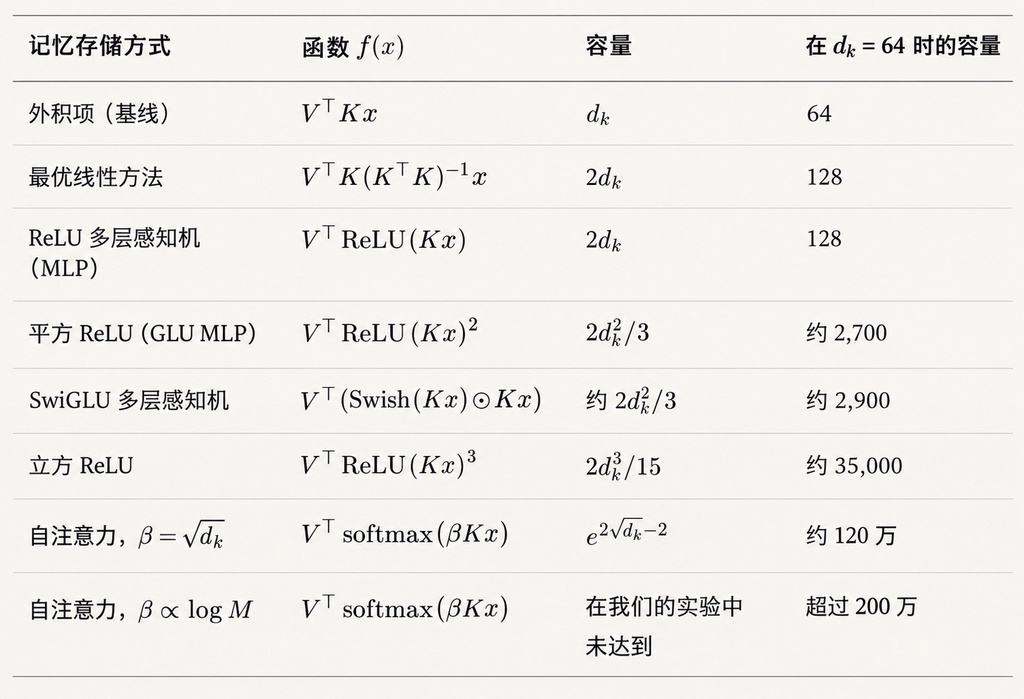
如果将这种非线性压制推向极限,使用包含无数次方的指数函数,就演变出了自注意力机制中的Softmax函数。指数函数能对不匹配的键施加极强的衰减。在64维空间中,配合合适的缩放系数,自注意力机制的记忆容量可直接突破120万个。若再根据上下文长度动态调整缩放比例,记忆容量甚至能达到近乎无界的规模。
从简单的线性矩阵相乘,到MLP的选择性压制,再到自注意力机制的指数级检索,Transformer的诞生并非偶然,而是一条为了追求极致记忆容量与高效检索的必然数学演进之路。
原文:https://alexwang.ai/posts/associative-memory/