研究发现,近半数受测AI问题在新模型中大幅减弱,但讨好用户等问题反而更明显。
AI编造学术参考文献曾让不少研究者头疼。一项新分析发现,较新的大语言模型已经很少引用不存在的文献,但这并不意味着虚假引用会立刻从学术论文中消失。
斯坦福大学的Owen Queen及同事梳理了2022年末至2025年末发表的研究,从中选出50种被广泛引用的大语言模型行为。他们用原论文中的提示词测试了2024年中至2026年末发布的20个模型,观察这些行为是否发生变化。
结果发现,近一半受测行为在较新的模型中已大幅减弱。研究人员将这些现象视为“过期”,它们从首次发表到大幅消退的平均时间约为16个月。这项分析发表于博客,尚未经过同行评审。
有些毛病消失得很快。例如,模型对简单数学问题过度思考的现象,在相关研究发表约一个半月后便不再明显。另一些则持续更久:模型倾向于用“坚韧”等词刻板描述黑人女性的现象,持续了三年以上。
还有三种行为在新模型中变得更加明显:迎合用户喜好、偏爱自己生成的文字,以及生成真正随机数字的能力不足。
虚构参考文献是改善较明显的问题之一。2023年的一项研究发现,当GPT-3.5被要求撰写文献综述时,55%的引用是编造的。新分析显示,模型编造引用的情况总体上随时间减少;受测的最新模型GPT-6.1 Sol是唯一没有虚构引用的模型。
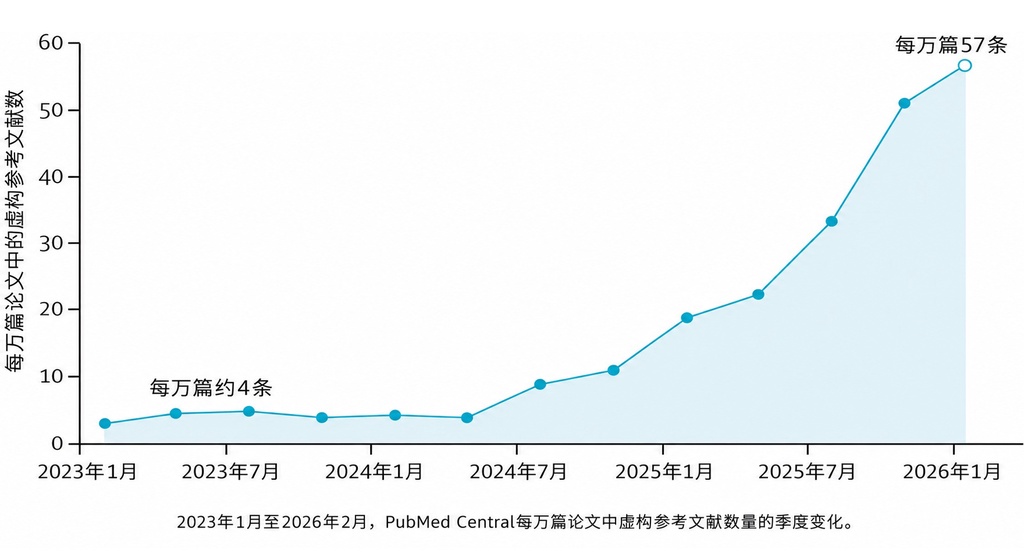
不过,论文中的情况仍在恶化。哥伦比亚大学的Maxim Topaz及同事分析了2023年初至2026年初发表的250万篇生物医学论文,发现虚构引用的比例增长了12倍。Topaz认为,使用AI的研究者越来越多,而且2026年发表的论文可能在更早时候使用更容易产生幻觉的模型撰写。
卡内基梅隆大学的Maarten Sap提醒,将某种AI行为称为“过期”可能过于简单。不同模型的训练和优化方式不同,有些模型可能只是更擅长避免测试中涉及的问题。了解模型为什么产生某种行为,与判断它能否完成任务同样重要。
原文:https://www.nature.com/articles/d41586-026-03753-1